Gobernanza, Privacidad y Control Presupuestario para LLMs.
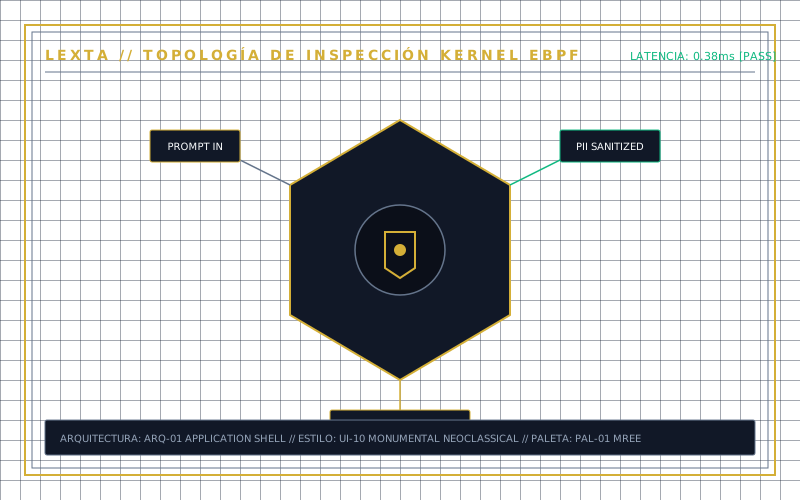
Investigamos y diseñamos una arquitectura proxy pre-flight que busca neutralizar la fuga de datos confidenciales y eliminar la incertidumbre financiera al utilizar modelos de lenguaje y routers de terceros como OpenRouter, ChatGPT y Claude.
El dilema de la adopción de IA: Innovación frente a pérdida de control.
Equipos enteros utilizan modelos de lenguaje para elevar su productividad, pero la falta de barreras perimetrales genera riesgos críticos de cumplimiento y costos desmedidos.
Fuga de PII en Texto y Adjuntos
Contratos en PDF, reportes en Excel y capturas escaneadas contienen datos personales, RFCs y cuentas bancarias que escapan hacia brokers externos y modelos no auditados, infringiendo GDPR y LFPDPPP.
#RiesgoRegulatorioFacturación Opaca e Impredecible
Sin techos de gasto por departamento o usuario, un prompt descuidado o un bucle en un agente de código genera miles de dólares en tokens consumidos sin alertas tempranas ni capacidad de detención automática.
#RiesgoFinancieroPérdida de Soberanía con Routers
Los enrutadores externos (OpenRouter, LiteLLM) ofrecen flexibilidad multimodelo, pero trasladan la información corporativa a proveedores cuya jurisdicción y retención son imposibles de certificar.
#GobernanzaPerimetralCinco hipótesis de diseño para un proxy de gobernanza robusto.
No creemos en soluciones mágicas. Diseñamos componentes desacoplados y auditables para resolver cada dimensión del problema sin ralentizar a los desarrolladores.
Inspección Celular y Multiformato en Memoria Volátil
Hipótesis de Diseño: La sanitización debe ocurrir antes de que la petición toque la red externa, extrayendo texto en más de 1,000 tipos de archivo (`.pdf`, `.xlsx`, `.docx`, `.zip`) en memoria RAM, sin escribir jamás archivos temporales en disco (Zero Data Retention).
- Modelos de procesamiento de lenguaje natural y validación algorítmica de checksums (RFC, CURP, CLABE, Luhn).
- Reconocimiento óptico forense (OCR) condicional aplicado únicamente a páginas escaneadas o imágenes incrustadas.
- Tasa objetivo de falsos bloqueos menor a 0.1% mediante proximidad semántica contextual.
Tokenización Criptográfica Biyectiva Efímera
Hipótesis de Diseño: La desensibilización no debe romper la gramática del prompt. Al sustituir datos reales por identificadores sintéticos coherentes, el LLM procesa la petición con total precisión contextual.
- Bóveda de mapeo temporal cifrada con AES-256-GCM que vive únicamente durante el ciclo de vida de la solicitud.
- Reconversión transparente de datos en la respuesta del modelo antes de entregarla al colaborador.
- Soporte proyectado para streaming de tokens (SSE) con buffer circular de detokenización al vuelo.
Escudo Perimetral para AI Routers (OpenRouter & Multi-LLM)
Hipótesis de Diseño: Lexta no compite con los routers ni pretende ser un selector inteligente de modelos; actúa como el guardián perimetral previo que otorga certeza legal y técnica antes de que la petición salga a cualquier broker.
- Permite a las organizaciones utilizar OpenRouter con total tranquilidad respecto a normativas de privacidad.
- Compatibilidad drop-in: solo requiere configurar la URL base en los SDKs de aplicación existentes.
- Registro inalterable de auditoría perimetral exportable a SIEMs corporativos.
Gobernanza FinOps Dual y Techos Presupuestarios Duros
Hipótesis de Diseño: El control de costos debe ser proactivo, no forense. Los techos presupuestarios deben operar a nivel jerárquico (Departamento y Usuario) con corte automático.
- Alertas blandas (*Soft Alerts*) al alcanzar el 80% del presupuesto asignado.
- Parada dura (*Hard-Budget Stop*) al 100% que bloquea nuevas peticiones hasta autorización superior.
- Contabilidad multidivisa calibrada contra las matrices oficiales de costos de tokens.
Aislamiento de Cargas y Resiliencia Anti-OOM (Bulkhead)
Hipótesis de Diseño: La extracción de texto y OCR en PDFs complejos es intensiva en cómputo. El proxy principal debe estar desacoplado del cluster de procesamiento mediante colas para evitar caídas por memoria saturada.
- Patrón Bulkhead implementado con colas RabbitMQ y control de contrapresión (QoS).
- Aislamiento de procesos: Si un adjunto malicioso agota recursos, solo se reinicia el worker de extracción.
- Garantía de alta disponibilidad para el tráfico de texto de baja latencia cotidiano.
Diseñado para responder a los dolores de tres líderes clave.
Construimos esta arquitectura escuchando las prioridades críticas de Ciberseguridad, Finanzas y Operaciones de Plataforma.
Fuga inadvertida de datos personales y código fuente en prompts hacia LLMs públicos, arriesgando multas millonarias y sanciones de GDPR/LFPDPPP.
Intercepción síncrona pre-flight con precisión semántica y visibilidad inalterable en SIEM corporativo.
Facturas imprevistas por consumo de tokens y falta de herramientas para atribuir y limitar el gasto de IA entre áreas operativas.
Límites presupuestarios duros (Hard-Stop 100%) por departamento y visibilidad financiera bimoneda en tiempo real.
Agentes pesados en endpoints que degradan el rendimiento de las máquinas de desarrollo y despliegues complejos que retrasan entregas.
Proxy perimetral transparente, despliegue en contenedores in-VPC e integración drop-in con la API de OpenAI.
Valida tus casos de uso y ayúdanos a calibrar la arquitectura.
Buscamos organizaciones que enfrenten retos reales de adopción de LLMs para contrastar nuestras hipótesis de ingeniería. Los participantes seleccionados recibirán acceso prioritario a las pruebas de laboratorio y sesiones técnicas 1 a 1.
Claridad absoluta sobre nuestro estado y visión.
Transparencia técnica antes de cualquier compromiso comercial.